IA y datos · UNIR
Deep learning para la identificación de objetos transneptunianos
Clasificación de recortes de 21×21 píxeles en TNOs reales o falsas detecciones: una red totalmente conectada (optimizadores, lote, épocas, matriz de confusión y batch normalization), una VGG6 con ajuste de hiperparámetros y dropout, y una ResNet50.
Introducción
En este trabajo se aborda un problema real de la astronomía mediante aprendizaje profundo: distinguir, en imágenes pequeñas de 21 × 21 píxeles, entre detecciones verdaderas de objetos transneptunianos (TNOs) y falsas detecciones producidas por el ruido. Los datos proceden de un sondeo de objetos cercanos a la Tierra realizado por Lori Allen y colaboradores con la cámara DECam del telescopio Blanco de 4 m (CTIO), e incluyen TNOs simulados (positivos verdaderos) y trayectorias sin fuentes conocidas (falsos positivos), con relaciones señal-ruido de 3 a 100. El objetivo es determinar cuántos TNOs hay en las imágenes finales. La dificultad es evidente: a baja señal-ruido, un positivo verdadero y un falso positivo son casi indistinguibles a simple vista, lo que justifica recurrir a redes neuronales.
El conjunto de 109.523 imágenes se dividió en un 80 % de entrenamiento (87.618), un 10 % de validación (10.952) y un 10 % de prueba (10.953). De ellas, 60.000 son TNOs simulados y 49.523, falsas detecciones: la clase TNO es ligeramente mayoritaria (≈ 55 %).
En la primera parte se emplea una red neuronal clásica totalmente conectada (FC, fully connected) para estudiar el efecto del optimizador, del tamaño de lote y del número de épocas, la interpretación de la matriz de confusión y el uso de la batch normalization. En la segunda se pasa a redes neuronales convolucionales (CNN): primero una VGG6, en la que se ajustan los hiperparámetros del optimizador y se incorporan capas de dropout, y finalmente una arquitectura mucho más profunda, ResNet50, con la que se busca mejorar el resultado.
I. Primera parte: red neuronal totalmente conectada
Se parte de un modelo secuencial con dos capas ocultas totalmente conectadas de 30 neuronas y activación ReLU, seguidas de una capa de salida softmax de 2 nodos (TNO frente a ruido). El entrenamiento consiste en encontrar los pesos y sesgos que minimizan la función de coste mediante descenso por gradiente y retropropagación.
1/5. Optimizador SGD frente a ADAM
¿Se han clasificado correctamente las imágenes de TNOs? ¿Por qué? En este primer experimento se entrena la red totalmente conectada con el optimizador SGD y los valores por defecto del enunciado: tamaño de lote (batch) = 1 y una sola época (epochs = 1), es decir, una única pasada por los datos actualizando los pesos imagen a imagen. La calidad se mide con la exactitud (proporción de imágenes bien clasificadas) y con la función de coste, tanto en entrenamiento como en validación. Como referencia, se considera que un modelo está bien entrenado cuando supera el ~90 % de exactitud.
Como se ve en la Tabla 1, el modelo no clasifica bien las imágenes de TNOs con el optimizador SGD: la exactitud ronda el 62 %, muy lejos del 90 %. En distintas ejecuciones, la exactitud de entrenamiento se movió entre el 62 % y el 66 %, con una exactitud de validación cercana al 54–57 %.
| Optimizador (lote = 1, 1 época) | Exactitud entren. | Exactitud valid. | Coste (loss) entren. | Coste (loss) valid. |
|---|---|---|---|---|
| SGD | 0,62 – 0,66 | 0,54 – 0,57 | ≈ 0,58 – 0,63 | ≈ 0,68 – 0,70 |
| ADAM | 0,93 | 0,95 | 0,18 (≈ ⅓ del de SGD) | 0,12 |
Tabla 1. Desempeño de la red totalmente conectada tras una época con tamaño de lote 1, comparando los optimizadores SGD y ADAM. Para SGD se indica el rango observado en varias ejecuciones; con ADAM, la exactitud supera el 90 % y la función de coste se reduce aproximadamente a una tercera parte.
El principal motivo de esta baja exactitud es la combinación del optimizador SGD (sensible a los mínimos locales) con un entrenamiento muy escaso: con un lote de una sola imagen y una sola época, la función de coste se aproxima a partir de un único ejemplo por paso, por lo que el modelo no llega a entrenarse adecuadamente.
Al repetir el experimento con un segundo optimizador, ¿mejora o empeora el resultado? ¿Por qué ese optimizador? Para el segundo experimento se escogió el optimizador ADAM, por ser el más habitual en una primera aproximación y uno de los mejores entre los métodos “simples” (existen versiones mejoradas, como ADAMW, entre otras). Con él, el resultado mejora muchísimo: se alcanza una exactitud superior al 90 % y un valor de la función de coste cercano a la tercera parte del obtenido con SGD. Además, en validación la exactitud aumenta y la función de coste disminuye, lo que confirma que el modelo queda bien entrenado.
2/5. Tamaño de lote y número de épocas
¿Mejora la clasificación respecto a n_epochs = 1 y batch_size = 1? ¿Por qué? ¿Cómo evolucionan los números durante el entrenamiento? ¿Hay sobreajuste? Se mantiene exactamente la misma red y el mismo optimizador SGD del apartado anterior; lo único que cambia es el régimen de entrenamiento: el tamaño de lote pasa de 1 a 435 y el número de épocas, de 1 a 200. Un lote es el subconjunto de imágenes que se usa para calcular el gradiente y actualizar los pesos en cada iteración; una época es una pasada completa por todo el conjunto de entrenamiento. Con 87.618 imágenes y lotes de 435, cada época son unas 202 iteraciones.
De esta manera se consigue una clasificación mejor: al aumentar el tamaño de lote y el número de épocas, la función de coste se minimiza mejor. Se obtiene una exactitud del 91,61 % en entrenamiento y del 91,02 % en validación, con valores de la función de coste de 0,2444 y 0,2575, respectivamente.
En cuanto a la evolución de los números: en cada iteración se calcula la función de coste sobre un lote y se actualizan los pesos, y ese resultado sirve de punto de partida para el lote siguiente. En consecuencia, dentro de cada época el coste va disminuyendo iteración a iteración y la exactitud va mejorando, y cada nueva época parte del resultado de la anterior. Cabe señalar que con muchas menos épocas ya se habría llegado a un buen resultado.
No se observa sobreajuste: la exactitud de validación acompaña a la de entrenamiento (queda apenas medio punto por debajo). Sí conviene señalar que, en algunas ejecuciones, el modelo arranca atascado en ≈ 0,55 (la exactitud que se obtendría prediciendo siempre la clase mayoritaria) y no progresa; se atribuye a una mala inicialización que cae en un mínimo local, y se resuelve reiniciando el entrenamiento o rehaciendo la partición.
3/5. Matriz de confusión y F1-score
¿Cómo se interpreta la matriz de confusión? ¿Cuál es el valor del parámetro F1-score?
- Exactitud (accuracy) ≈ 0,92.
- Sensibilidad (recall) = VP / (VP + FN) = 0,92 / (0,92 + 0,08) = 0,92.
- Especificidad = VN / (VN + FP) = 0,92 / (0,92 + 0,08) = 0,92.
- Precisión = VP / (VP + FP) ≈ 0,93, teniendo en cuenta que el 55 % de las imágenes son TNOs: 0,92 · 0,548 / (0,92 · 0,548 + 0,08 · 0,452).
Estos valores indican un modelo muy homogéneo, con una exactitud del 92 %: no da más falsos positivos que falsos negativos, por lo que no presenta ningún sesgo en este sentido. Con una precisión de 0,93 y una sensibilidad de 0,92, el F1-score resulta:
F1 = 2 · (precisión · sensibilidad) / (precisión + sensibilidad) = 2 · (0,93 · 0,92) / (0,93 + 0,92) ≈ 0,93
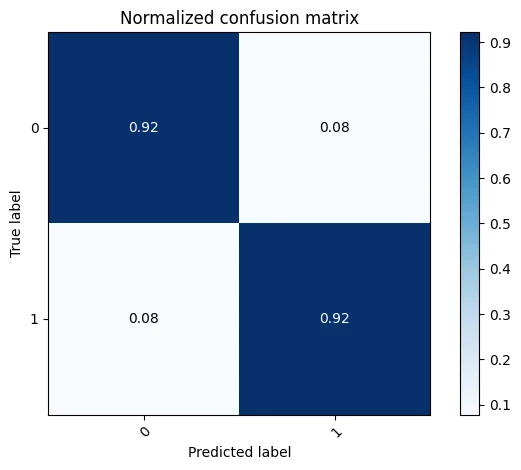
En la matriz, las filas son la clase verdadera y las columnas, la predicha; la clase 0 corresponde a los falsos positivos (ruido) y la clase 1, a los positivos verdaderos (TNO). La diagonal recoge los aciertos: el 92 % del ruido se clasifica como ruido y el 92 % de los TNOs como TNO. Los errores son simétricos (8 % y 8 %), de ahí que el modelo no muestre sesgo hacia ninguna clase.
4/5. Curvas de entrenamiento
¿Qué muestran las gráficas? ¿Hay sobreajuste? La primera gráfica representa la evolución de la función de coste (loss): cae bruscamente en las primeras épocas y luego desciende muy despacio hasta estabilizarse en ≈ 0,25. Se muestran el coste de entrenamiento (azul) y el de validación (naranja), que permanecen prácticamente superpuestos, con la validación apenas por encima al final. La segunda gráfica muestra la exactitud, con el comportamiento inverso: sube de golpe hasta ≈ 0,90 en las primeras épocas y luego mejora muy poco a poco hasta ≈ 0,91. El grueso del aprendizaje ocurre en las primeras épocas, lo que confirma que con bastantes menos épocas se habría llegado a un resultado similar.
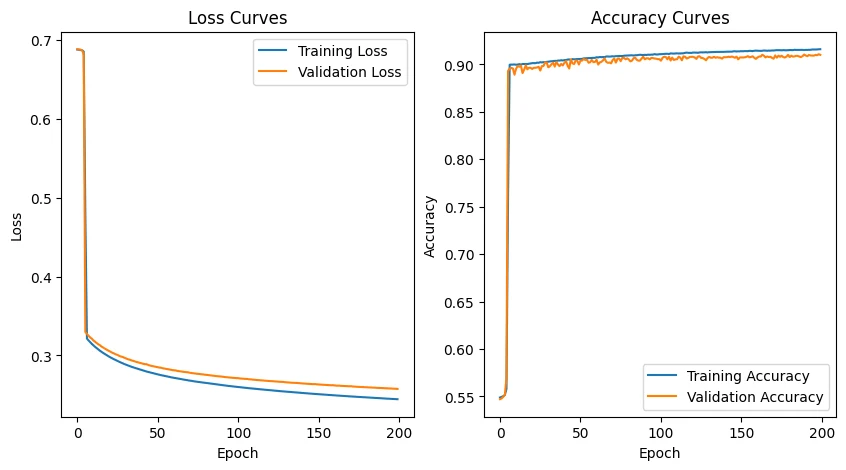
En este caso no hay sobreajuste. La señal de sobreajuste sería que la curva de entrenamiento siguiera mejorando mientras la de validación se estanca o empeora, abriendo una brecha creciente entre ambas. Aquí ocurre lo contrario: las curvas de entrenamiento y validación evolucionan juntas y en paralelo durante todo el proceso, con una diferencia mínima (≈ 0,916 frente a ≈ 0,910 de exactitud). El modelo generaliza igual de bien a datos no vistos.
5/5. Batch normalization
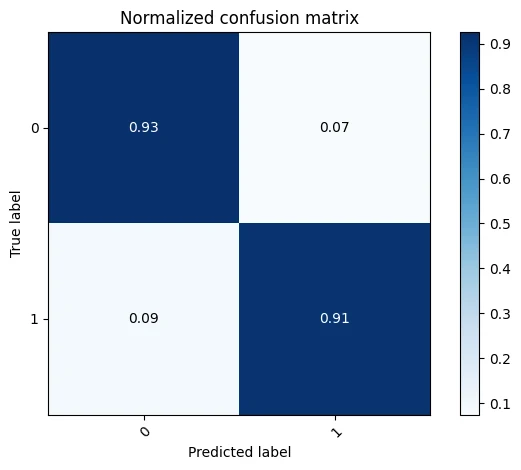
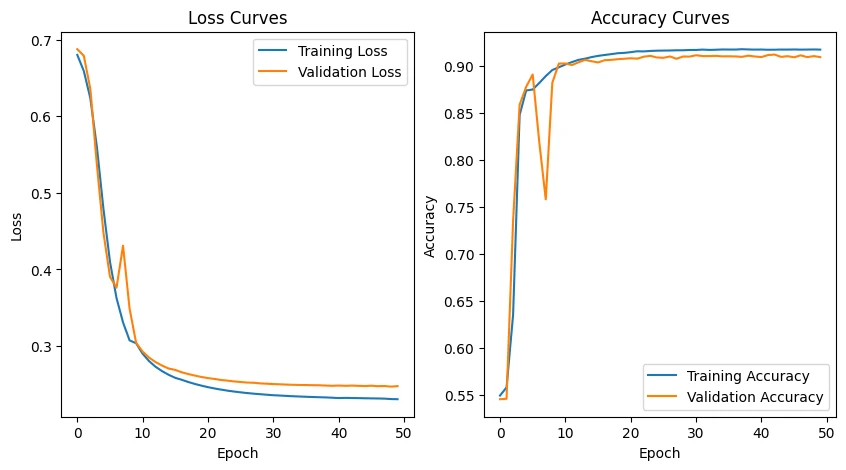
¿Ha mejorado la batch normalization la clasificación de las imágenes de TNOs? La batch normalization (BN) normaliza las activaciones de la capa para que tengan media 0 y varianza 1, lo que estabiliza y acelera el entrenamiento. Para evaluar su efecto se repitió el entrenamiento de la misma red, con el mismo SGD y el mismo lote de 435, pero con BN y solo 50 épocas (frente a las 200 del apartado anterior).
La exactitud final apenas cambia: se mantiene en ~92 % (0,91 → 0,917), con una precisión de 0,93 y una sensibilidad de 0,91. Es decir, la BN no mejora de forma apreciable la exactitud, pero sí acelera notablemente la convergencia: como se ve en las gráficas, en muy pocas épocas se alcanzan el mínimo del coste y la exactitud máxima, y la curva de validación es casi coincidente con la de entrenamiento. Se consigue así, en una fracción de las épocas, el mismo ~92 % que antes requería 200.
Conviene retener esta observación: en esta red sencilla y bien integrada, la batch normalization ayuda. En la segunda parte se verá que la misma técnica, en un contexto distinto, puede comportarse de manera muy diferente.
II. Segunda parte: redes neuronales convolucionales (CNN)
Las redes convolucionales están diseñadas para trabajar con imágenes: en lugar de conectar cada neurona a toda la imagen, aplican filtros (kernels) a pequeñas regiones, lo que reduce la complejidad y aporta cierta invariancia frente a pequeñas traslaciones. Sus componentes básicos son las capas convolucionales, las funciones de activación no lineales, las capas de pooling (que resumen regiones, típicamente con max pooling) y las capas totalmente conectadas finales. Se emplean primero una arquitectura VGG6 y, por último, una ResNet50.
1/3. VGG6: parámetros por defecto y ajuste del optimizador
Resultados con los parámetros por defecto del optimizador. Con los parámetros por defecto (learning rate = 0,01, momentum = 0,75, nesterov = False), y usando los mismos valores de épocas y tamaño de lote que en la primera parte para poder comparar, la VGG6 daba un resultado sorprendentemente inferior: la exactitud no pasaba del 65 % en ninguno de los intentos. Era, por tanto, un mal modelo para este ejercicio.
Ajuste del learning rate y del momentum. A partir de ahí se siguieron varios pasos:
- Se redujo el learning rate hasta 1e-6, con un resultado algo mejor, pero sin llegar al 70 %.
- Se cambiaron también el número de épocas (50) y el tamaño del lote (64) y se probaron distintos valores de momentum, sin que el resultado mejorara. A partir de aquí se empezaron a registrar los resultados que recoge la Tabla 2.
- Se probó incluso con 500 y 1000 épocas, sin éxito.
- Finalmente, se volvió a un tamaño de lote de 256, con 50–100 épocas, subiendo de nuevo el learning rate a 0,01 (porque cuanto más pequeño era, menos avanzaba el aprendizaje y más épocas necesitaba) y bajando el momentum de 0,75 a 0,5, ya que, al suavizar un poco el gradiente, este parámetro favorecía el aprendizaje.
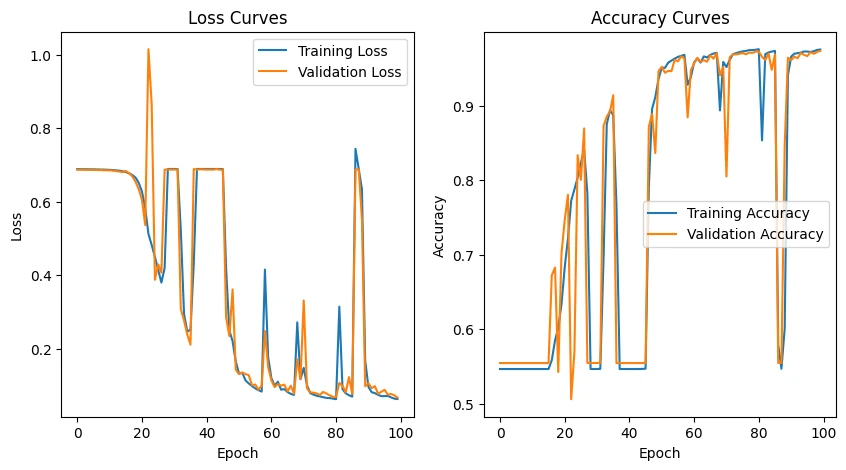
Aun así, estos cambios por sí solos no dieron un buen resultado. En ese momento se observó que las propias salidas daban pistas. Al revisar las métricas con atención apareció un patrón que se repetía: aunque la exactitud de entrenamiento podía subir, la validación se comportaba de forma errática e incoherente con ella. El val_loss llegaba a dispararse a valores enormes (del orden de miles) y la val_accuracy oscilaba en torno al nivel del azar (Figura 4), mientras la matriz de confusión mostraba que el modelo asignaba una única clase a todos los ejemplos. Es decir, el modelo parecía aprender sobre los datos de entrenamiento, pero era incapaz de generalizar.
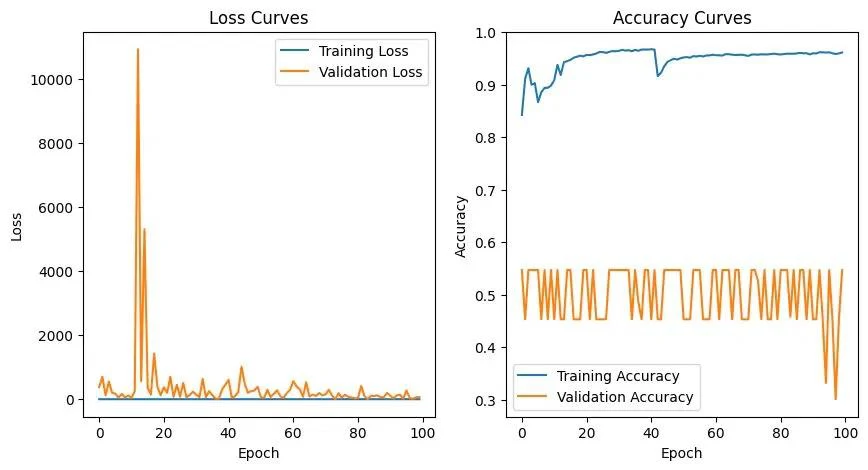
Esa discrepancia tan marcada entre entrenamiento y validación fue la pista clave, y llevó a sospechar de la capa BatchNormalization. Esta capa normaliza las activaciones con la media y la desviación del lote durante el entrenamiento, pero en validación utiliza un promedio móvil de esas estadísticas acumulado durante el entrenamiento. Con una única capa BatchNormalization aislada y un entrenamiento inicialmente inestable, ese promedio móvil quedaba mal estimado: la red normalizaba con una “regla” distinta al validar y sus salidas se descontrolaban. Eso explicaba que entrenara bien pero fallara por completo en validación.
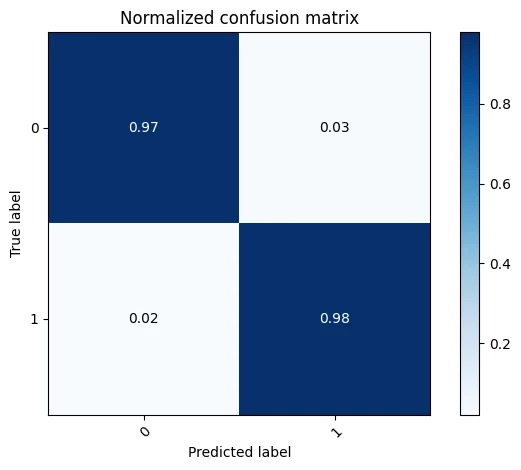
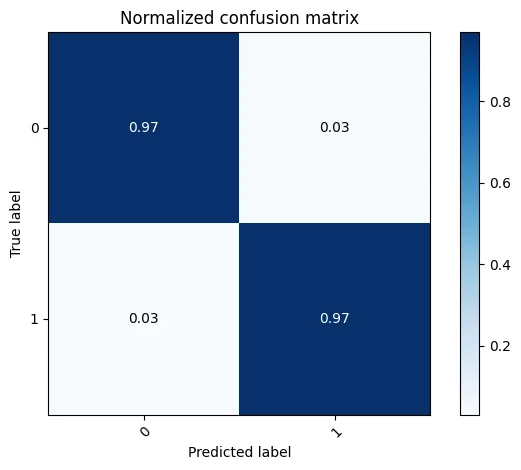
Al comentar la línea de BatchNormalization, la red pasó a realizar el mismo cálculo en entrenamiento y en validación, y la inestabilidad desapareció. Con la configuración final (learning rate = 0,01, momentum = 0,5, nesterov = True, batch size = 256 y 100 épocas, sin BatchNormalization), el modelo convergió correctamente: las curvas de entrenamiento y validación ascienden juntas hasta ≈ 0,97 de exactitud (señal de que no hay sobreajuste) y el coste baja hasta ≈ 0,07. La matriz de confusión final alcanza 0,97 y 0,98 de aciertos por clase. Aunque en las curvas se aprecian picos puntuales (ruido propio del SGD), el modelo se recupera de ellos y mantiene la convergencia (Figura 5).
Las predicciones sobre imágenes individuales (Figura A1 del Anexo) confirman el buen desempeño: se clasifican correctamente tanto las fuentes compactas y centradas como los campos más difusos y ruidosos.
En conclusión, el buen resultado no procede de un único parámetro, sino del conjunto: un learning rate suficientemente grande (0,01) para aprender sin necesitar un número desmesurado de épocas; un momentum moderado (0,5) que suaviza el avance sin que el optimizador “se pase de largo”; un batch size grande (256) que estabiliza las curvas; y épocas suficientes (100) para converger. Pero el factor decisivo fue identificar que la capa BatchNormalization estaba saboteando la generalización: al retirarla, todos los demás ajustes pudieron reflejarse por fin en un modelo estable, reproducible y con una exactitud cercana al 97 %. A diferencia de la red sencilla del apartado anterior (donde la BatchNormalization, bien integrada y con un entrenamiento estable, aceleraba la convergencia), aquí se trata de una única capa aislada con un entrenamiento inicialmente inestable, condiciones en las que sus estadísticas móviles quedan mal estimadas y la capa pasa de ayudar a perjudicar.
2/3. Capas de dropout
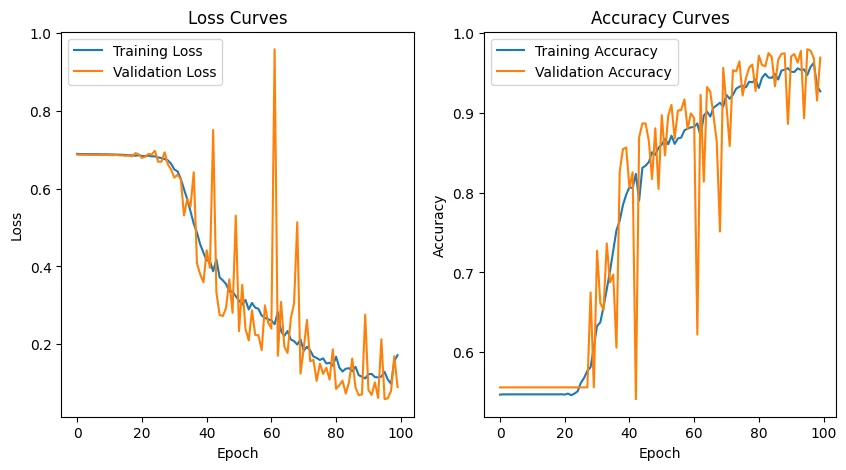
¿Mejora la clasificación anterior al usar capas de dropout? En términos de exactitud, no. El modelo con dropout alcanza prácticamente el mismo resultado que sin él: ≈ 97 % en ambos casos (matriz de confusión 0,97/0,97 con dropout frente a 0,97/0,98 sin él). La diferencia está dentro del ruido propio del entrenamiento.
El dropout es una técnica de regularización cuya función es reducir el sobreajuste, es decir, cerrar la brecha entre la exactitud de entrenamiento (alta) y la de validación (más baja). La capa de dropout anula aleatoriamente una fracción de las neuronas (25–50 %) en cada paso de entrenamiento, lo que obliga a la red a no depender de neuronas concretas. En este modelo esa brecha prácticamente no existía: ya sin dropout, las curvas de entrenamiento y validación evolucionaban juntas (una vez retirada la capa BatchNormalization). Como el modelo no sobreajustaba, el dropout no tenía margen para mejorar la exactitud: no se puede mejorar una generalización que ya es buena.
Lo que sí aportó el dropout fue robustez y reproducibilidad: sin él, los resultados eran más variables entre ejecuciones (en algunas, el entrenamiento se desestabilizaba y colapsaba a la solución trivial, ~0,77 y luego la clase mayoritaria), mientras que con dropout el buen resultado se obtuvo de forma consistente y reproducible (Figura 6).
En conclusión, el dropout no mejoró la exactitud (el modelo ya generalizaba bien sin él), pero hizo que el buen resultado fuera más estable y reproducible; no perjudica y es buena práctica mantenerlo. La Tabla 2 resume el camino recorrido en el ajuste de la VGG6, en el que aparecieron dos problemas opuestos: con un learning rate demasiado pequeño, el modelo apenas se movía (el coste no bajaba de 0,69), mientras que con un learning rate alto pero un momentum elevado aprendía durante unas pocas épocas y enseguida “se pasaba de largo”, volviendo a colapsar a la clase mayoritaria. El equilibrio apareció con learning rate = 0,01 y momentum = 0,5.
| Prueba | Learning rate | Momentum | Nesterov | Lote | Épocas | Dropout | Resultado |
|---|---|---|---|---|---|---|---|
| Por defecto | 0,01 | 0,75 | False | 64 | 50 | No | No aprende: se estanca prediciendo siempre la clase mayoritaria (acc ≈ 0,547; loss ≈ 0,69). |
| 1 | 0,00001 | 0,75 | True | 64 | 50 | No | Demasiado lento: el coste apenas baja y no despega de 0,69. |
| 2 | 0,001 | 0,9 | True | 64 | 50 | No | Aprende unas pocas épocas (val acc ≈ 0,85) y colapsa de nuevo a la clase mayoritaria. |
| 3 | 0,0001 | 0,5 | True | 64 | 50 | No | Demasiado lento; casi no avanza. |
| 4 | 0,01 | 0,5 | True | 64 | 50 | Sí | Aprende (acc ≈ 0,68), pero con curvas muy ruidosas y aún subiendo. |
| 5 | 0,01 | 0,5 | True | 256 | 100 | Sí | Converge de forma estable y reproducible: acc entren./valid. ≈ 0,95–0,97; matriz 0,97/0,97. |
| 6 | 0,01 | 0,5 | True | 256 | 100 | No | Variable: en algunas ejecuciones converge a ≈ 0,97 (matriz 0,97/0,98); en otras se desestabiliza y colapsa (~0,77 → 0,547). Figura 5. |
Tabla 2. Resumen del proceso de ajuste de la VGG6: combinaciones de learning rate, momentum, nesterov, tamaño de lote, épocas y dropout evaluadas, con el resultado obtenido en cada caso.
Las pruebas 5 y 6 son la comparación limpia del dropout: la misma configuración en todo, con la única diferencia de activarlo o no. La prueba 5 se reprodujo varias veces y siempre dio ≈ 0,97; la 6 daba resultados distintos según la inicialización aleatoria, lo que muestra el efecto estabilizador del dropout. En todas las pruebas de ajuste se usó nesterov = True; la fila “Por defecto” usa los parámetros iniciales del optimizador (learning rate = 0,01, momentum = 0,75, nesterov = False) con el lote y las épocas con los que se empezaron a registrar las pruebas (64 y 50). La capa BatchNormalization, presente en el modelo original, se retiró tras las primeras pruebas porque desestabilizaba la validación; las pruebas 1–6 ya van sin ella.
3/3. ResNet50 frente a VGG6
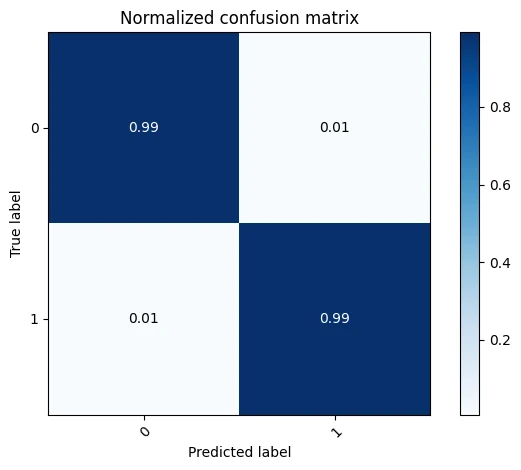
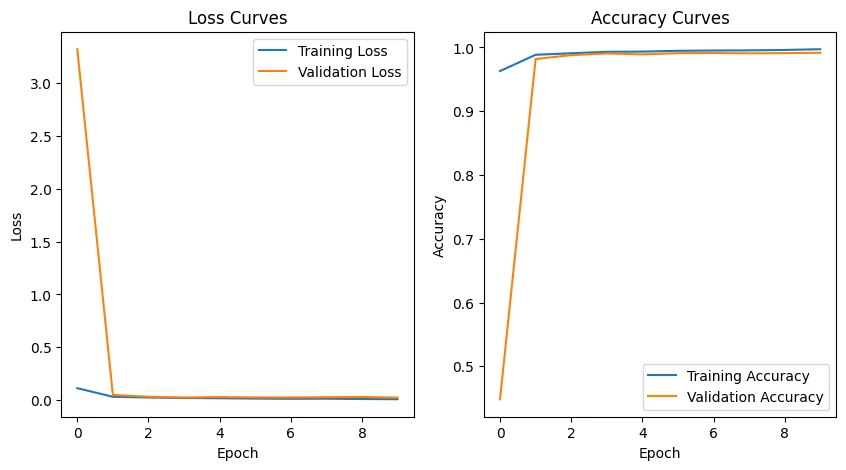
¿Mejora la ResNet la clasificación de los TNOs realizada por la VGG? Sí, la ResNet50 mejoró claramente la clasificación.
| Métrica | VGG6 (mejor configuración) | ResNet50 |
|---|---|---|
| Exactitud de validación | ≈ 0,97 | ≈ 0,99 |
| Matriz de confusión | 0,97 / 0,97 | 0,99 / 0,99 |
| Épocas para converger | ≈ 100 (tras mucho ajuste) | ≈ 99 % ya en la época 3 |
| Optimizador | SGD ajustado (lr 0,01; momentum 0,5; nesterov) | SGD por defecto (sin ajustar) |
| Coste computacional | Bajo (6 capas, ~2 s por época) | Alto (50 capas, ~19 s por época) |
Tabla 3. Comparación del desempeño de la VGG6 (en su mejor configuración) y de la ResNet50 en la clasificación de TNOs.
- Mejora en exactitud: se pasa de ≈ 97 % (VGG6) a ≈ 99 % (ResNet50). En términos de error, este baja de ≈ 3 % a ≈ 1 % por clase, es decir, se reduce aproximadamente a un tercio. En la detección de TNOs, donde interesa minimizar tanto los falsos positivos como las detecciones reales perdidas, esa reducción es significativa.
- Aprendizaje mucho más rápido: la ResNet alcanzó ≈ 99 % ya en la época 3, mientras que la VGG necesitó ≈ 100 épocas y un ajuste fino del learning rate, el momentum, el lote y el dropout.
- Mucho más robusta: la ResNet dio buenos resultados desde el principio incluso con el optimizador SGD por defecto, justo el que dejaba estancada a la VGG. No hizo falta ninguna búsqueda de hiperparámetros.
¿Por qué es mejor? La ResNet50 es una red mucho más profunda (50 capas) con conexiones residuales: bloques de suma o “atajos”. Estas conexiones permiten que el gradiente fluya directamente a través de la red y evitan el problema del desvanecimiento del gradiente que afecta a las redes profundas convencionales, lo que le permite aprender representaciones más ricas y distinguir mejor entre detecciones reales y falsas. Además, usa BatchNormalization de forma consistente en toda la red, lo que estabiliza el entrenamiento (de hecho, en la época 1 la val_accuracy fue baja, 0,45, porque las estadísticas internas de BatchNormalization aún no estaban estimadas; a partir de la época 2 se estabilizaron y la validación subió a 0,98).
Contrapartida: la mejora tiene un coste. La ResNet50 es mucho más pesada (50 capas frente a 6) y requiere bastantes más recursos: unos 19 s por época frente a unos 2 s de la VGG6, es decir, unas diez veces más (las 10 épocas entrenadas llevaron algo más de 3 minutos; 100 épocas supondrían una media hora). Para una tarea en la que la precisión en la detección de TNOs es crítica, la mejora justifica el coste; si los recursos fueran limitados, la VGG6, con ≈ 97 %, sigue siendo una opción muy razonable.
Conclusión
Sobre un mismo problema, separar TNOs reales de falsos positivos en recortes de 21 × 21 píxeles, este experimento muestra cómo la elección de la arquitectura y de los hiperparámetros condiciona por completo el resultado.
En la red totalmente conectada se establecieron los fundamentos: con SGD, un lote de tamaño 1 y una sola época, el modelo no aprende (≈ 62 %), pero basta con cambiar a ADAM, o con aumentar el lote y las épocas, para superar el 90 %. La matriz de confusión resultó equilibrada (0,92 en ambas clases, F1 ≈ 0,93) y las curvas, paralelas, descartaron el sobreajuste; en esta red sencilla, la batch normalization ayudó, alcanzando los mismos resultados con menos iteraciones.
En la VGG6 el panorama se complicó: los parámetros por defecto no pasaban del 65 % y ningún ajuste aislado lo resolvía. La clave no estaba en un único valor, sino en detectar que una capa de BatchNormalization aislada, con un entrenamiento inestable, estimaba mal sus estadísticas y arruinaba la validación (val_loss del orden de miles, predicción de una sola clase). Al retirarla y fijar learning rate = 0,01, momentum = 0,5, lote de 256 y 100 épocas, la red convergió de forma estable hasta ≈ 97 %. El dropout, añadido después, no mejoró la exactitud (el modelo ya generalizaba bien), pero sí aportó robustez y reproducibilidad. Finalmente, la ResNet50 mejoró la clasificación de ≈ 97 % a ≈ 99 % (el error baja aproximadamente a un tercio), aprendiendo mucho más rápido y con menos ajuste gracias a su profundidad y a sus conexiones residuales, a costa de un coste computacional bastante mayor.
La lección sobre la batch normalization resume bien el trabajo: la misma técnica ayudó en la red simple, perjudicó en la VGG6 cuando se usó aislada y con un entrenamiento inestable, y resultó esencial en la ResNet50, donde se aplica de forma consistente en toda la red y con un entrenamiento estable. No es, por tanto, una técnica “buena” o “mala” en sí misma: su efecto depende de cómo se integre en la arquitectura y de la estabilidad del entrenamiento. La elección final del modelo es, en la práctica, un compromiso entre la exactitud alcanzada y los recursos computacionales disponibles.
Disponibilidad de datos y código
Todos los datos utilizados en este estudio se obtuvieron del cuaderno de Jupyter del laboratorio, que contiene además los resultados y los detalles de las ejecuciones y las pruebas realizadas, que amplían y justifican esta memoria.
Referencias
- Datos del laboratorio: sondeo de objetos cercanos a la Tierra (Allen, L., y colaboradores) con la cámara DECam del telescopio Blanco de 4 m del CTIO; ficheros
stamps_sources.npy(positivos verdaderos) ystamps_noise.npy(falsos positivos), facilitados por el profesorado de la asignatura.
Anexo